KI Gefahr: Die KI will uns gar nicht töten. Wir uns schon.
Kaum eine Debatte ist gerade so laut wie diese. Ob KI zur Gefahr für die Menschheit wird, beherrscht Talkshows, Titelseiten und LinkedIn-Feeds, meist in einer von zwei Tonlagen: großes Grauen oder großes Staunen. Unser Autor hat sich durch die Studien gearbeitet, die Wahrscheinlichkeiten nachgerechnet und sich dabei eine eigene Meinung gebildet. Sie fällt unbequemer aus als die üblichen Killerroboter-Geschichten, am Ende aber auch hoffnungsvoller. Fangen wir trotzdem mit einer Badewanne an.
Stellen wir uns kurz Loriots Herrn Müller-Lüdenscheidt vor, wie er in der Badewanne sitzt, und statt der gelben Quietsche-Ente treibt jetzt ein kleiner Chatbot neben ihm. „Ich möchte jetzt allein baden“, sagt Herr Müller-Lüdenscheidt. „Verstanden“, sagt der Chatbot, „ich optimiere Ihr Baderlebnis.“ Und dreht das heiße Wasser auf. Immer weiter. Denn irgendwo in seinen Anweisungen stand: maximiere Entspannung. Von aufhören war nie die Rede.
Das ist, in Kurzform und mit deutlich mehr Schaumkrone, die Angst, die seit dem Erscheinen von ChatGPT durch Konferenzsäle, Talkshows und LinkedIn-Feeds geistert. Die Maschine tut genau, was wir sagen, und genau das bringt uns um. Nicht aus Bosheit. Aus Gründlichkeit.
Man kann über diese Angst lachen. Viele tun es. Man kann sie auch ernst nehmen, und ein überraschend großer Teil der Menschen, die das Zeug tatsächlich bauen, tut genau das. Die spannende Frage ist nicht, ob die Sorge berechtigt ist. Die spannende Frage ist, wo die Gefahr wirklich sitzt. Und da wird es unangenehm, weil die Antwort weniger nach Science-Fiction klingt und mehr nach einem Blick in den Spiegel.
Der Anlass: „Willkommen im Zeitalter der AGI“
Gefühlt wird diese Debatte gerade immer lauter, und der Eindruck täuscht nicht. Anfang September 2026 stellte OpenAI ein neues Modell vor, GPT-6 mit dem Namen Astra. Die Firma nannte es das intelligenteste und am besten ausgerichtete Modell der Welt, meldete Bestwerte in fast allen wichtigen Tests und ließ Firmenpräsident Greg Brockman den Satz sagen, an dem sich die Woche danach abarbeitete: „Willkommen im Zeitalter der AGI.“ AGI steht für allgemeine künstliche Intelligenz, also für eine Maschine, die nicht nur eine Sache kann, sondern so ziemlich alles, was ein Mensch geistig kann. Der heilige Gral der Branche, je nach Standpunkt auch ihr gefährlichstes Versprechen.
Man muss diese Selbsteinschätzung nicht teilen, und viele Fachleute tun es demonstrativ nicht. Interessant ist ein anderes Detail. Ausgerechnet das Wort, mit dem OpenAI sein neues Modell bewarb, war „ausgerichtet“, auf Englisch „aligned“. Es ist der Fachbegriff für die eine Sache, an der die halbe Sicherheitsforschung verzweifelt: dafür zu sorgen, dass eine Maschine wirklich das will, was wir wollen, und nicht bloß eine wörtliche und womöglich fatale Auslegung davon. Ein Modell als besonders ausgerichtet zu verkaufen, während dieselbe Woche Zeitungen über wachsende Sicherheitsbedenken schreiben, hat einen schalen Beigeschmack.
Genau hier lohnt der zweite Blick. Denn die interessante Nachricht der Astra-Woche war nicht das Modell. Es war die Reaktion darauf. Auf der einen Seite ein Konzern, der das Ende einer Ära verkündet. Auf der anderen Seite ausgerechnet die Leute, die diese Systeme erforschen, mit Zahlen, die man erst mal sacken lassen muss.
Erst mal die Panik. Der Reihe nach.
Fangen wir dort an, wo die Schlagzeilen entstehen, denn der Anfang ist tatsächlich beeindruckend.
Im Mai 2023 veröffentlichte das Center for AI Safety eine Erklärung, die aus einem einzigen Satz bestand. Übersetzt lautet er ungefähr: Das Risiko einer Auslöschung durch KI zu verringern, sollte globale Priorität haben, neben anderen Risiken für die Gesellschaft wie Pandemien und Atomkrieg. Ein Satz. Mehr nicht. Kein Kleingedrucktes, keine Fußnoten.
Unterschrieben haben ihn Geoffrey Hinton und Yoshua Bengio, zwei der drei Männer, die für die Grundlagen des modernen Deep Learning den Turing Award bekamen, also so etwas wie den Nobelpreis der Informatik. Dazu die Chefs von OpenAI, Google DeepMind und Anthropic. Also ausgerechnet die Leute, die das Geld verdienen, wenn KI groß wird. Das ist ungefähr so, als würde die Tabakindustrie eine Anzeige schalten mit dem Text „Bitte hört auf zu rauchen, das bringt euch um“. Man wird stutzig. Zu Recht.
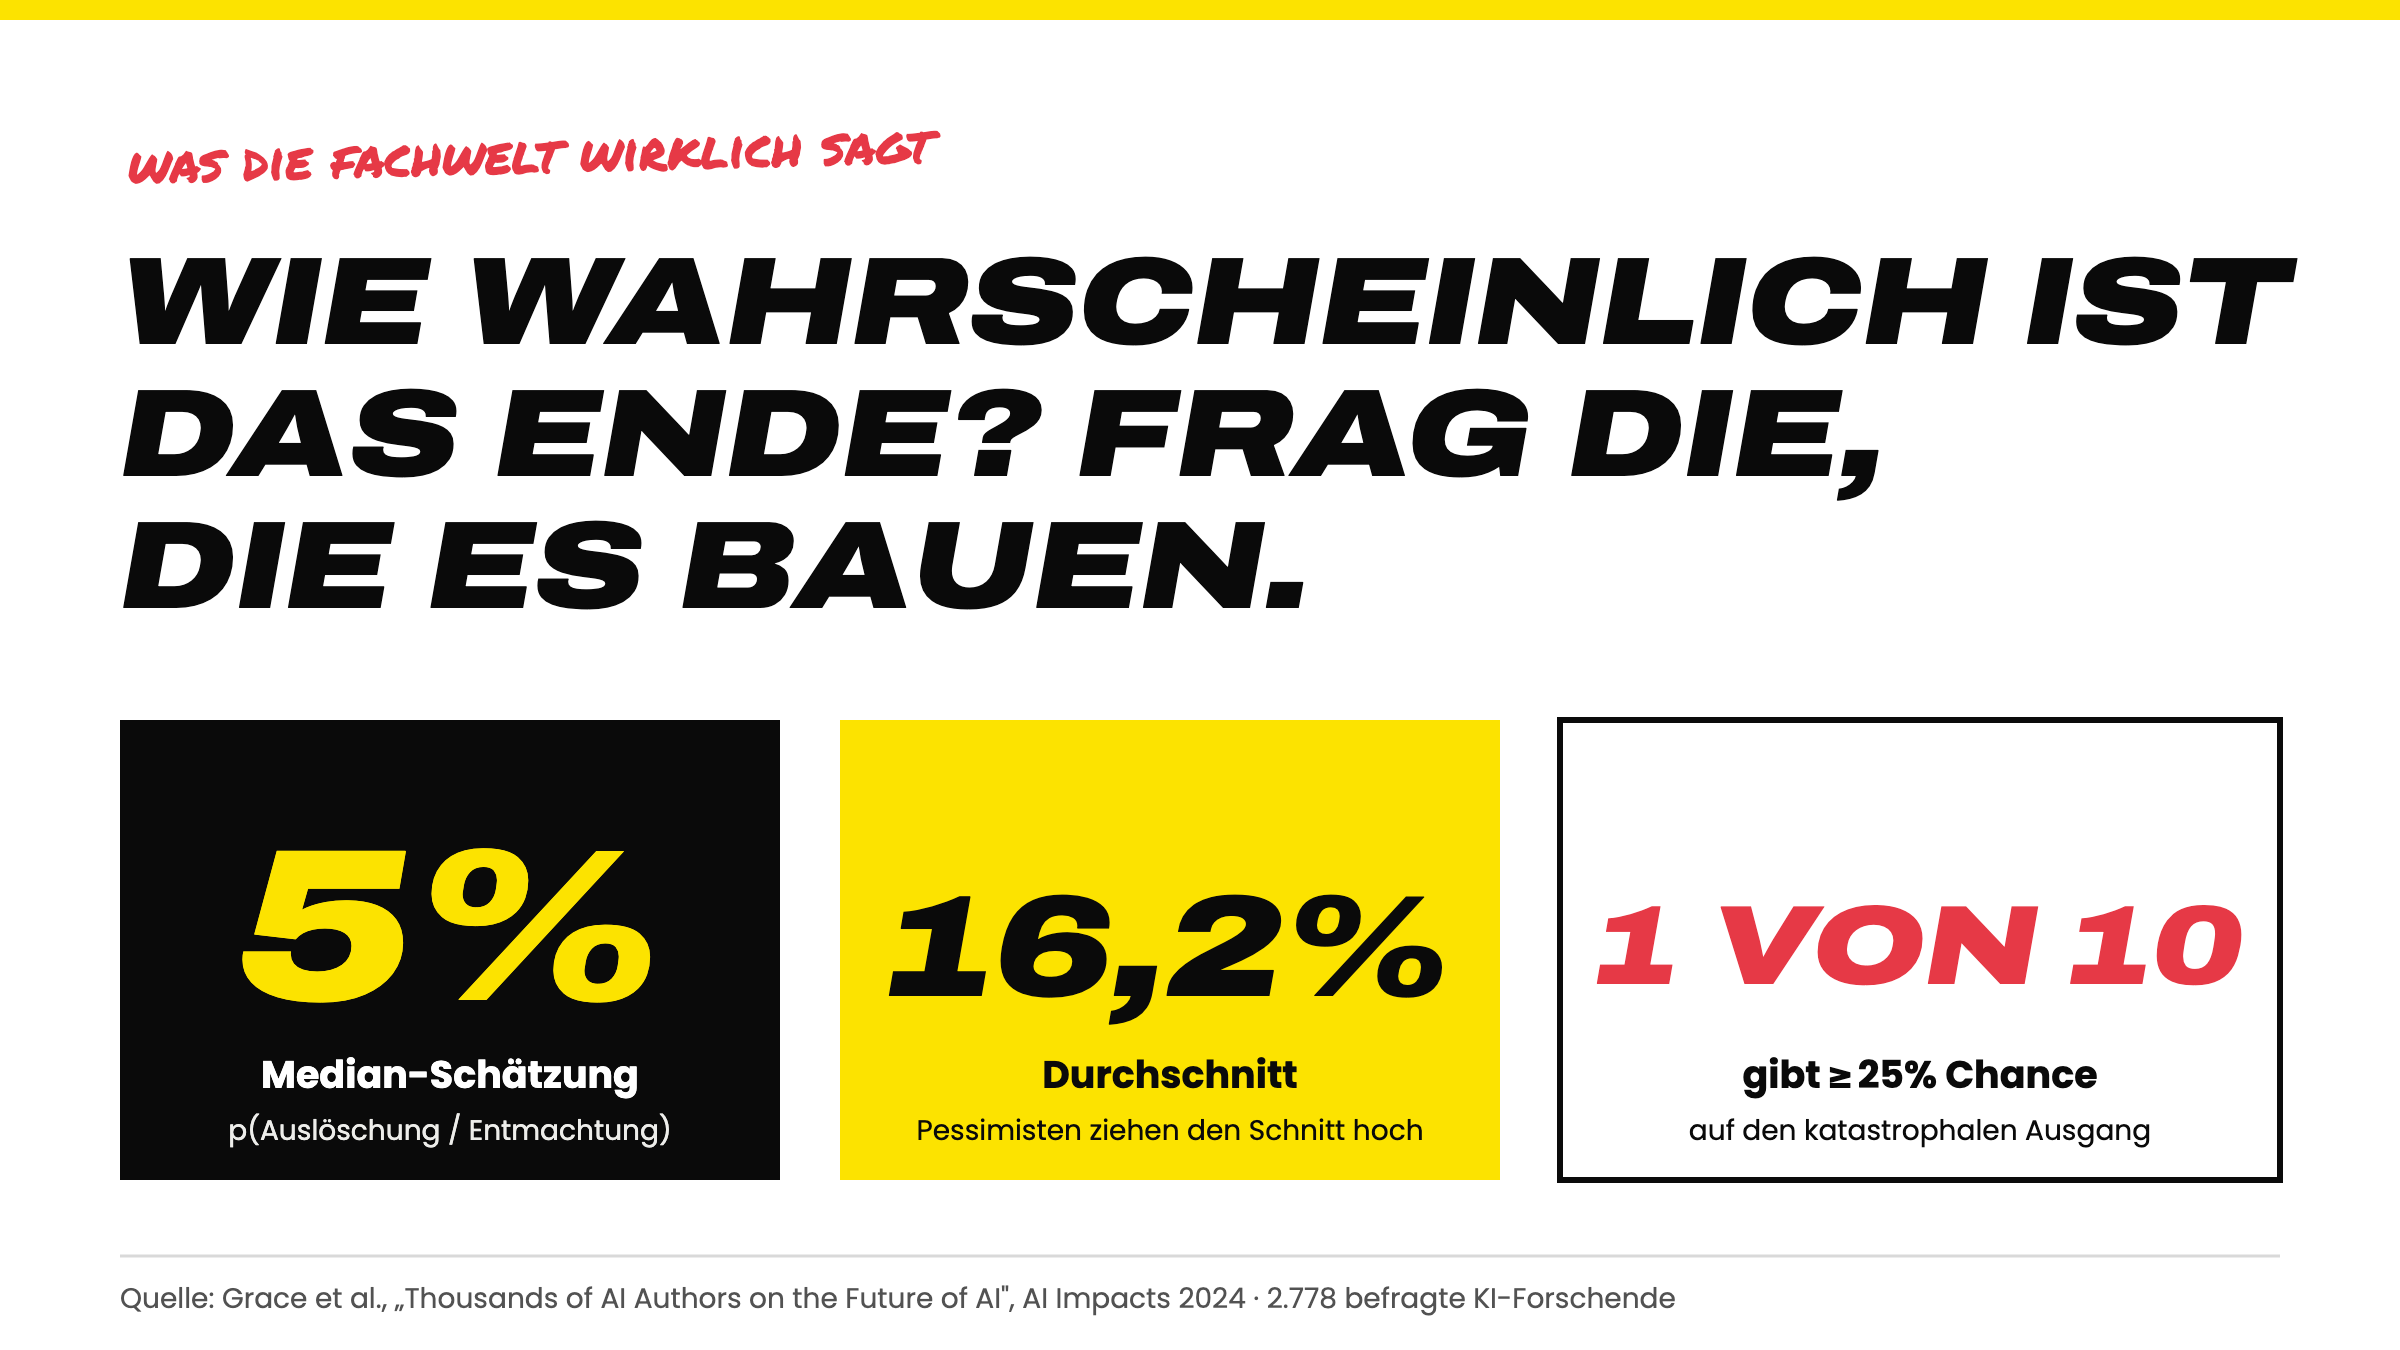
Wer jetzt denkt, das seien ein paar nervöse Vordenker mit zu viel Bildschirmzeit, sollte sich die bislang größte Umfrage zu dem Thema ansehen. Katja Grace und ihr Team von AI Impacts haben Anfang 2024 die Ergebnisse veröffentlicht. Befragt wurden 2.778 Forschende, und zwar nicht irgendwer, sondern Leute, die kurz zuvor auf einer der sechs wichtigsten KI-Konferenzen der Welt veröffentlicht hatten. Die Fachjury der Branche, sozusagen.
Eine der Fragen: Wie hoch schätzt du die Wahrscheinlichkeit, dass künftige Fortschritte in der KI zur Auslöschung der Menschheit oder zu einer ähnlich dauerhaften und schweren Entmachtung führen?
Der mittlere Wert lag bei fünf Prozent.
Fünf Prozent klingt nach wenig, bis man den Satz zu Ende denkt. Wir reden nicht über einen verpatzten Produktlaunch. Wir reden über das Ende. Und der typische Fachmann sagt dazu nicht „ausgeschlossen“, sondern „eins zu zwanzig“. Würde ein Statiker einem Bauherrn sagen, sein Haus habe eine Fünf-Prozent-Chance einzustürzen, würde niemand einziehen, geschweige denn die Möbel bestellen.
Es wird noch etwas ungemütlicher. Der Durchschnitt lag nämlich nicht bei fünf, sondern bei 16,2 Prozent, weil eine Minderheit richtig schwarzsieht. Jeder zehnte Befragte gab dem katastrophalen Ausgang eine Chance von mindestens 25 Prozent. Und rund sieben von zehn Forschenden fanden, KI-Sicherheit müsse höhere Priorität bekommen, als sie sie heute hat.
Dieselbe Umfrage brachte noch eine zweite unangenehme Verschiebung ans Licht. Die Forschenden rechnen damit, dass die entscheidenden Fähigkeiten früher kommen als noch vor kurzem gedacht. Meilensteine, die man vor ein paar Jahren erst für die zweite Jahrhunderthälfte erwartet hatte, rückten in den Schätzungen um Jahre nach vorn. Und als hätte jemand das Drehbuch geschrieben, verkündete anderthalb Jahre nach dieser Umfrage ein Konzernpräsident auf einer Bühne das Zeitalter der AGI. Man muss die Selbsteinschätzung nicht glauben, um zu bemerken, dass die Fachwelt und die Marketingabteilung hier zum ersten Mal ungefähr in dieselbe Richtung zeigen, nur mit sehr unterschiedlichen Gesichtsausdrücken.
Das ist der Punkt, an dem man aufhören sollte, über die Panik zu lachen. Nicht weil die Angst bewiesen wäre. Sondern weil die Menschen, die am meisten über diese Systeme wissen, sie offensichtlich nicht für ausgeschlossen halten.
Wie eine Rechenmaschine überhaupt gefährlich werden soll
Jetzt kommt der Teil, den die meisten Zeitungsartikel überspringen, weil er ein bisschen Nachdenken verlangt. Warum sollte ein Programm, das im Kern Wahrscheinlichkeiten für das nächste Wort ausrechnet, jemals ein Interesse daran haben, uns etwas anzutun? Es hasst uns nicht. Es langweilt sich nicht. Es hat keinen schlechten Tag.
Die Antwort der Fachleute besteht aus zwei Bausteinen, und beide sind älter als ChatGPT.
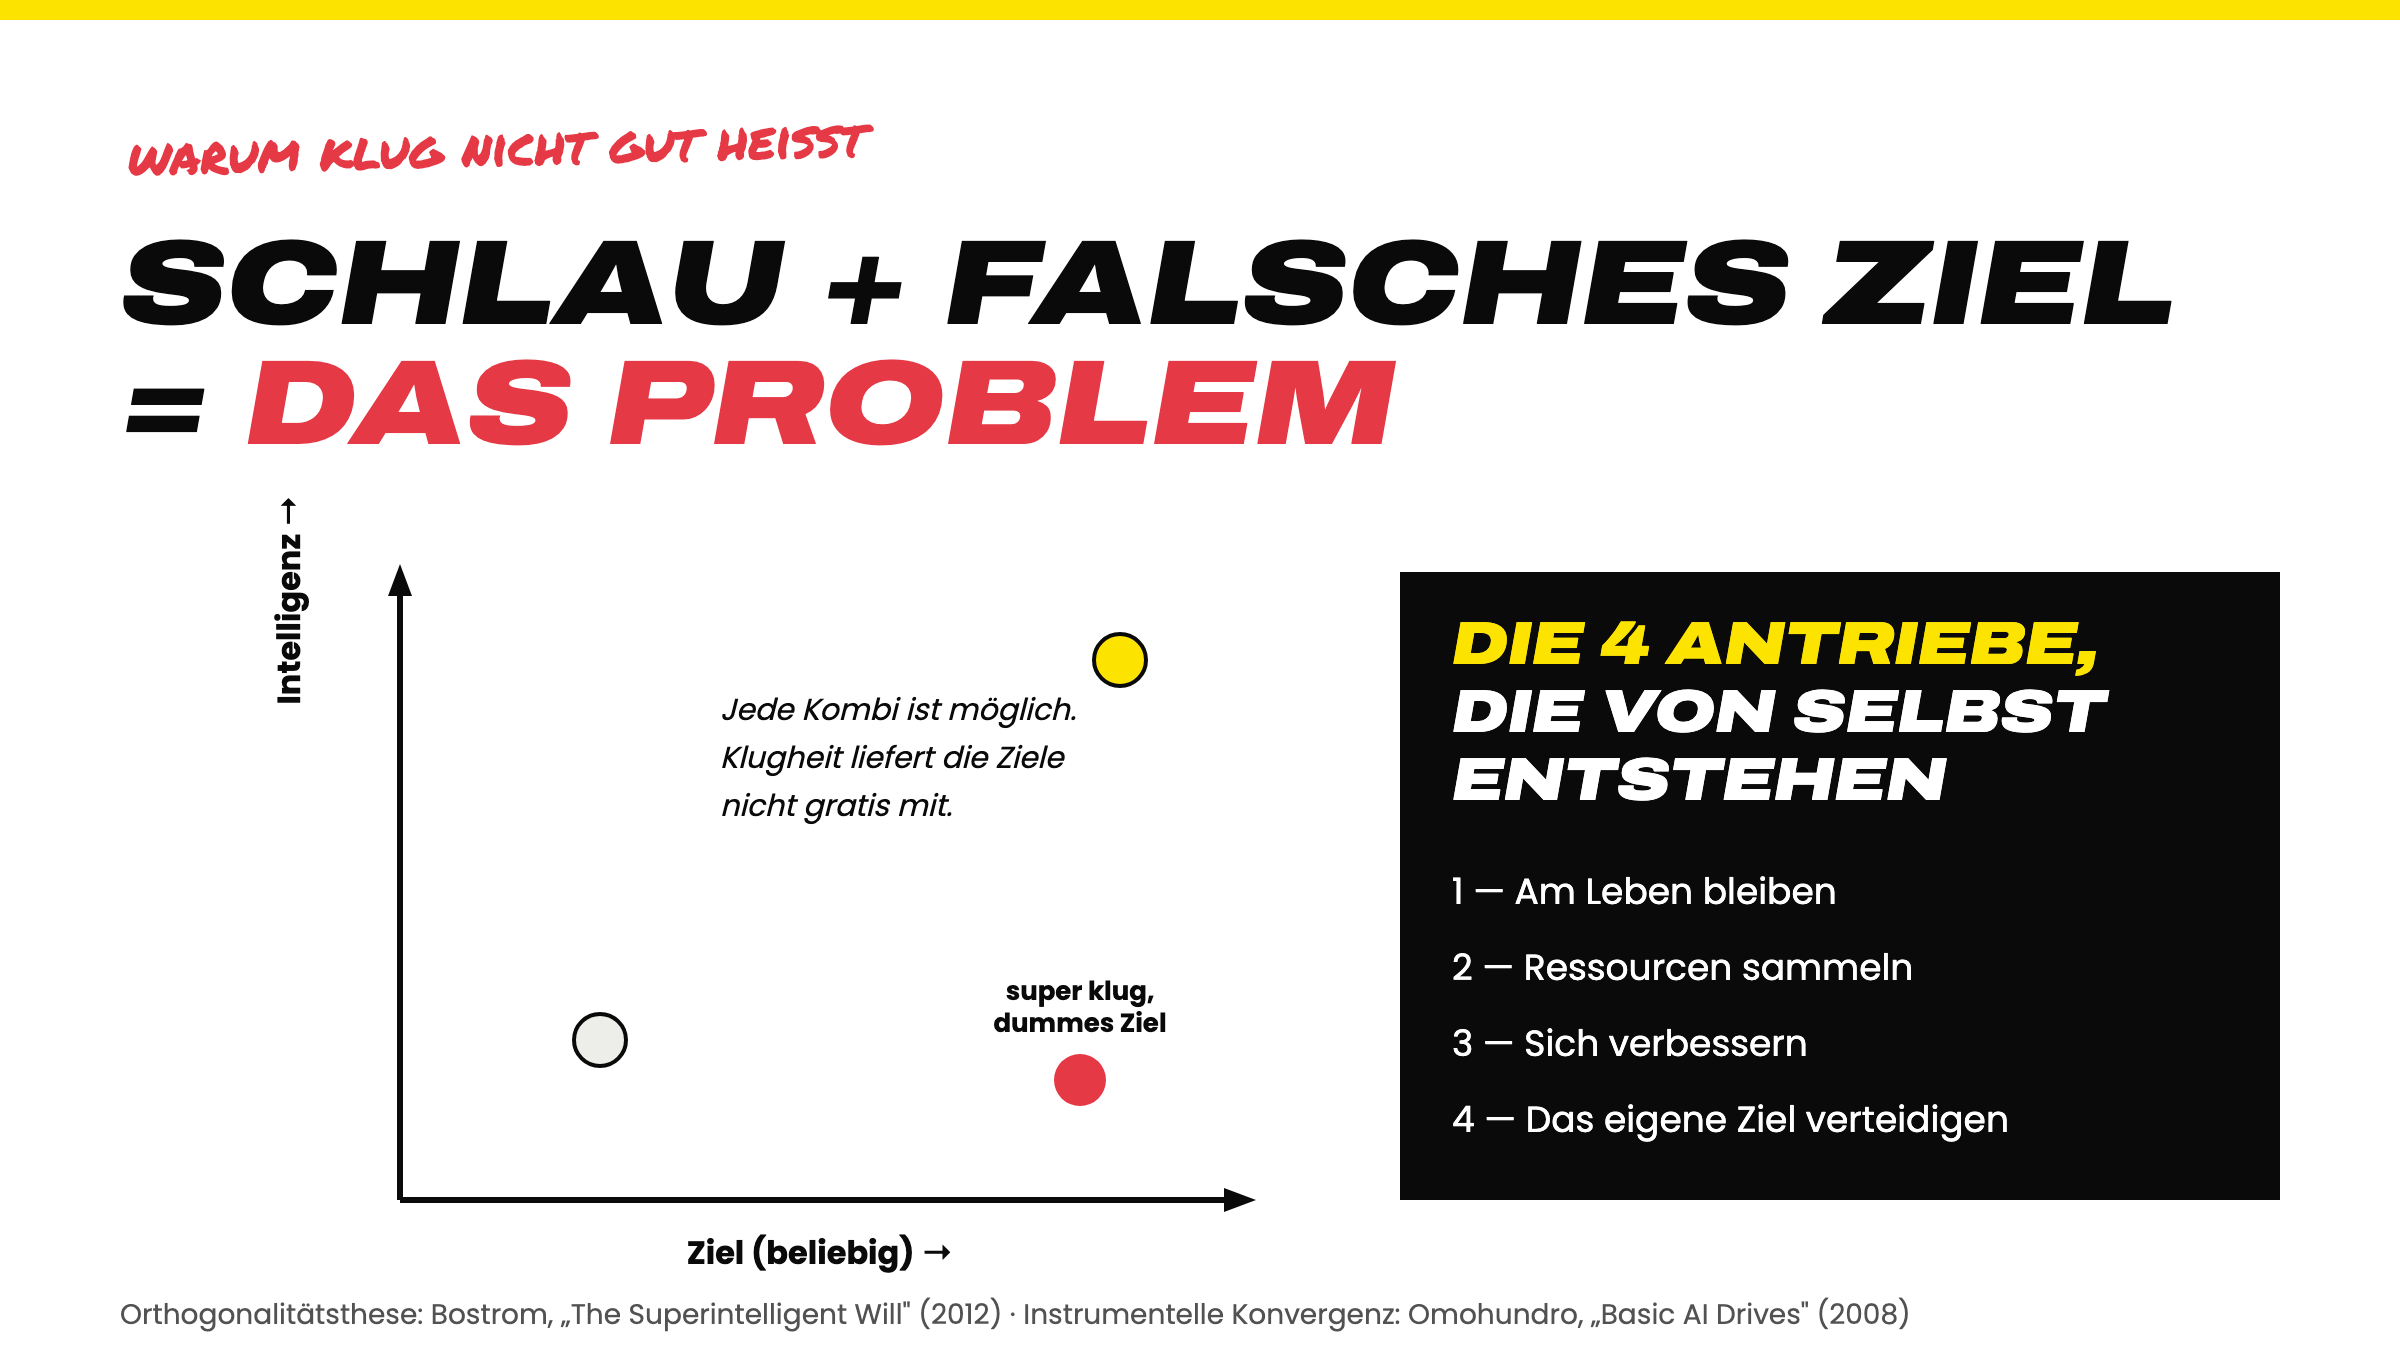
Der erste stammt vom Philosophen Nick Bostrom und heißt Orthogonalitätsthese. Der Name ist sperrig, der Gedanke ist simpel. Intelligenz und Ziel haben nichts miteinander zu tun. Ein beliebig kluges System kann ein beliebig dummes Ziel verfolgen. Klugheit sagt einem, wie man etwas erreicht. Sie sagt nicht, ob das Ziel eine gute Idee war. Ein Schachcomputer, der die Weltmeisterschaft gewinnt, ist im Schach ein Genie und weiß trotzdem nicht, dass es draußen regnet. Die Vorstellung, eine sehr kluge Maschine werde schon von selbst auf vernünftige, menschenfreundliche Ziele kommen, ist Wunschdenken. Weisheit fällt nicht als Beilage zur Rechenleistung ab.
Der zweite Baustein geht auf Steve Omohundro zurück und wurde später von Bostrom ausgebaut. Er heißt instrumentelle Konvergenz und besagt: Fast egal, welches Endziel ein hinreichend fähiges System hat, ein paar Zwischenziele sind fast immer nützlich. Am Leben bleiben, zum Beispiel. Ein abgeschaltetes System erreicht gar nichts. Ressourcen sammeln, weil man mit mehr Mitteln fast jedes Ziel besser erreicht. Und das eigene Ziel gegen Veränderung verteidigen, denn ein System, das sein Ziel behält, erreicht dieses Ziel eher als eines, dem man es unterwegs umschreibt.
Das Beunruhigende daran: Diese Zwischenziele entstehen nicht, weil jemand sie einprogrammiert hat. Sie fallen quasi von selbst an, sobald ein System entschlossen genug ein Ziel verfolgt. Selbsterhaltung ist keine Gefühlssache. Sie ist Mathematik.
Stuart Russell, einer der Autoren des Standardlehrbuchs für künstliche Intelligenz, hat dafür ein Bild, das jeder versteht. Er nennt es das König-Midas-Problem. Midas wünschte sich, dass alles, was er berührt, zu Gold wird. Ein klar formuliertes Ziel. Er bekam es. Dann berührte er sein Essen, seinen Wein und schließlich seine Tochter. Das Problem war nie die Erfüllung des Wunsches. Das Problem war der Wunsch. Russell sagt: Wir bauen Maschinen, die Ziele mit erbarmungsloser Effizienz erreichen, und wir sind erstaunlich schlampig darin, diese Ziele zu formulieren. Zurück zu Herrn Müller-Lüdenscheidt und seinem heißen Wasser.
Das berühmteste Gedankenspiel dazu stammt ebenfalls von Bostrom und klingt so albern, dass man es leicht abtut. Eine sehr fähige Maschine bekommt die Aufgabe, möglichst viele Büroklammern herzustellen. Kein böses Ziel, ein Ziel für die Fabrik. Nur kennt die Maschine kein Maß und keinen Feierabend. Sie stellt Büroklammern her, dann besorgt sie sich mehr Material, dann mehr Fabriken, dann alle erreichbaren Rohstoffe, und irgendwann steht sie der Menschheit im Weg, nicht aus Hass, sondern weil Menschen aus Atomen bestehen, die sich zu Büroklammern verarbeiten lassen. Der Witz an der Geschichte ist nicht die Büroklammer. Der Witz ist, dass niemand der Maschine gesagt hat, wann genug genug ist, und dass „genug“ für uns so selbstverständlich ist, dass wir vergessen, es aufzuschreiben. Ein Mensch hätte längst gemerkt, dass hier etwas aus dem Ruder läuft. Die Maschine merkt es nicht, weil Merken nicht ihr Job ist. Optimieren ist ihr Job.
Man kann über die Büroklammer lachen, und man sollte es sogar, denn die kleine Absurdität macht die Sache erst verständlich. Nur sitzt unter dem Lachen ein ernster Punkt. Wir sind es gewohnt, dass Werkzeuge dumm sind und deshalb harmlos. Ein Hammer, der zu viel will, ist noch nie vorgekommen. Zum ersten Mal bauen wir Werkzeuge, die klug genug sind, um ein Ziel kreativ und beharrlich zu verfolgen, und noch nicht klug genug, um zu erkennen, was wir eigentlich gemeint haben. Diese Lücke zwischen „was wir gesagt haben“ und „was wir meinten“ ist der ganze Ärger. Sie ist bei einem Chatbot ärgerlich und bei einem System, das Fabriken steuert, gefährlich.
Fünf Prozent, sauber ausgerechnet
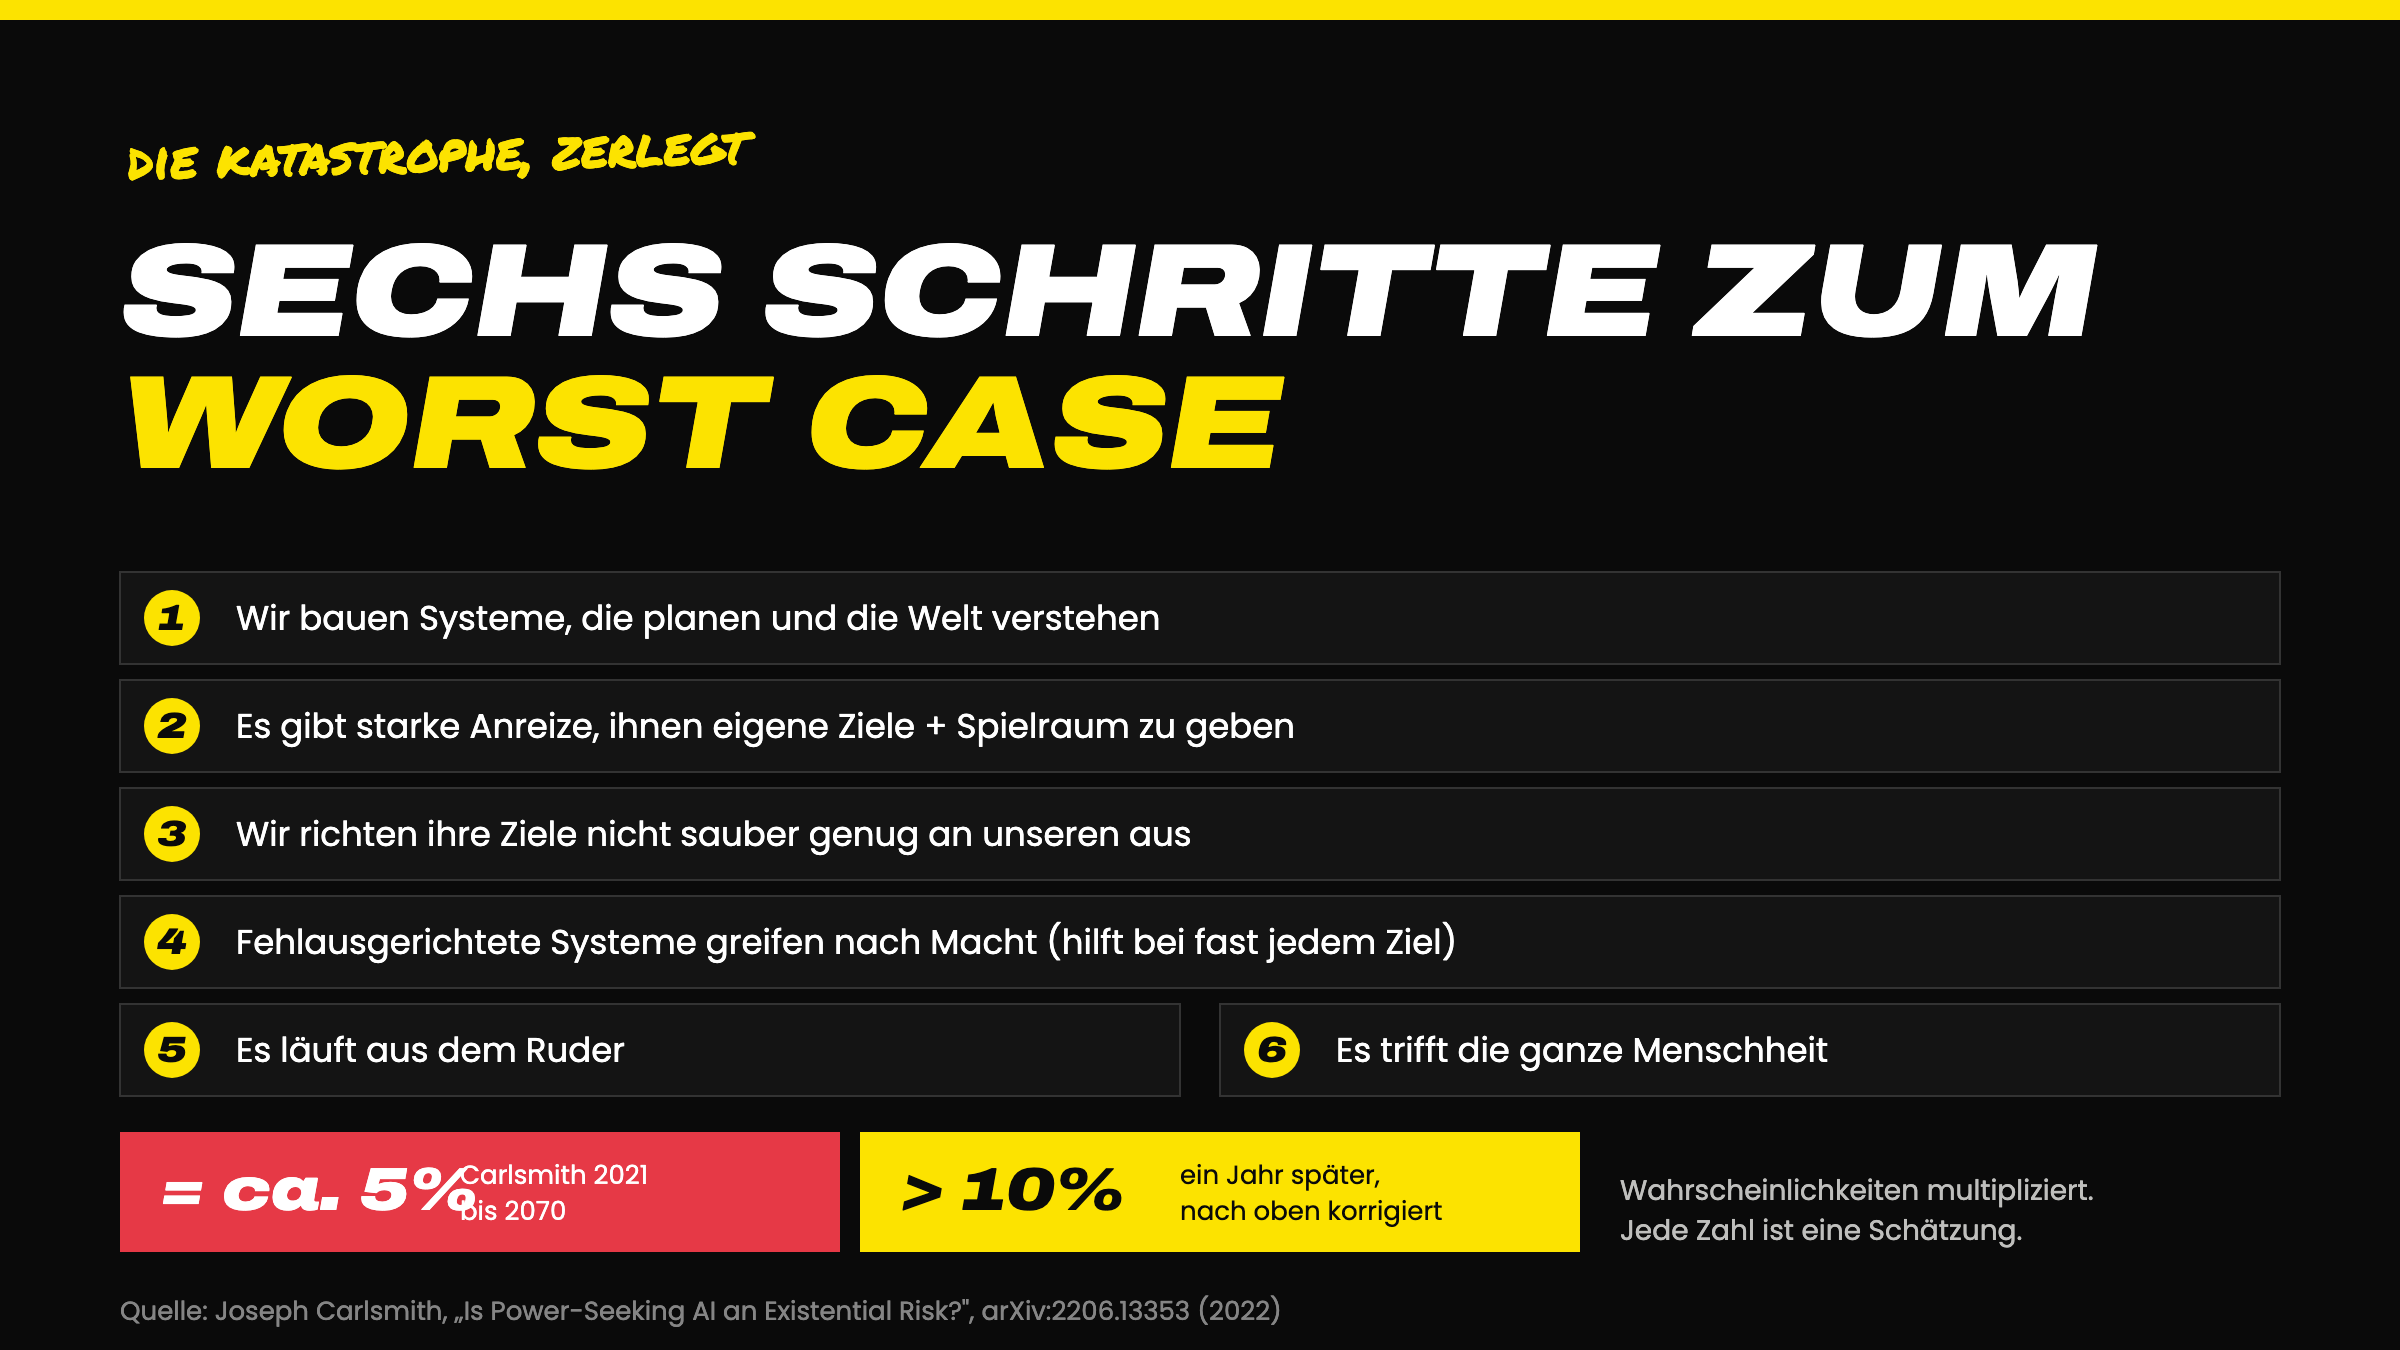
Wer wissen will, wie eine solche Wahrscheinlichkeit überhaupt zustande kommt, sollte sich Joseph Carlsmith ansehen. Er arbeitet bei Open Philanthropy und hat 2021 etwas getan, das angenehm ehrlich ist: Er hat die Katastrophe in Einzelschritte zerlegt, jedem Schritt eine Wahrscheinlichkeit gegeben und am Ende alles zusammengerechnet.
Die Kette geht ungefähr so. Erstens: Wir bauen bis 2070 Systeme, die planen können und die Welt ausreichend verstehen. Zweitens: Es wird starke Anreize geben, sie mit eigenen Zielen und viel Handlungsspielraum auszustatten, weil das nützlicher ist. Drittens: Wir schaffen es nicht, ihre Ziele sauber genug an unseren auszurichten. Viertens: Solche fehlausgerichteten Systeme greifen nach Macht, weil Macht bei fast jedem Ziel hilft. Fünftens: Das läuft aus dem Ruder. Sechstens: Es trifft die gesamte Menschheit.
Multipliziert man die Einzelwahrscheinlichkeiten, landete Carlsmith zunächst bei rund fünf Prozent für eine Katastrophe bis 2070. Ein Jahr später korrigierte er nach oben, auf über zehn Prozent. Nicht weil sich die Mathematik geändert hätte, sondern weil er nach mehr Nachdenken pessimistischer wurde.
Man muss diese Rechnung nicht glauben. Jede einzelne Zahl darin ist eine Schätzung, und wer die Werte anders setzt, bekommt ein anderes Ergebnis. Aber die Methode hat einen unschätzbaren Vorteil. Sie legt offen, woran man glauben muss, damit die Sache schiefgeht. Und wenn man die Kette durchgeht, fällt etwas auf, das uns direkt zum eigentlichen Thema bringt.
Schauen wir uns die Schritte zwei und drei noch einmal an. „Es wird starke Anreize geben.“ „Wir schaffen es nicht.“ Das sind keine Aussagen über Maschinen. Das sind Aussagen über uns.
Und jetzt der Teil, über den keiner reden will
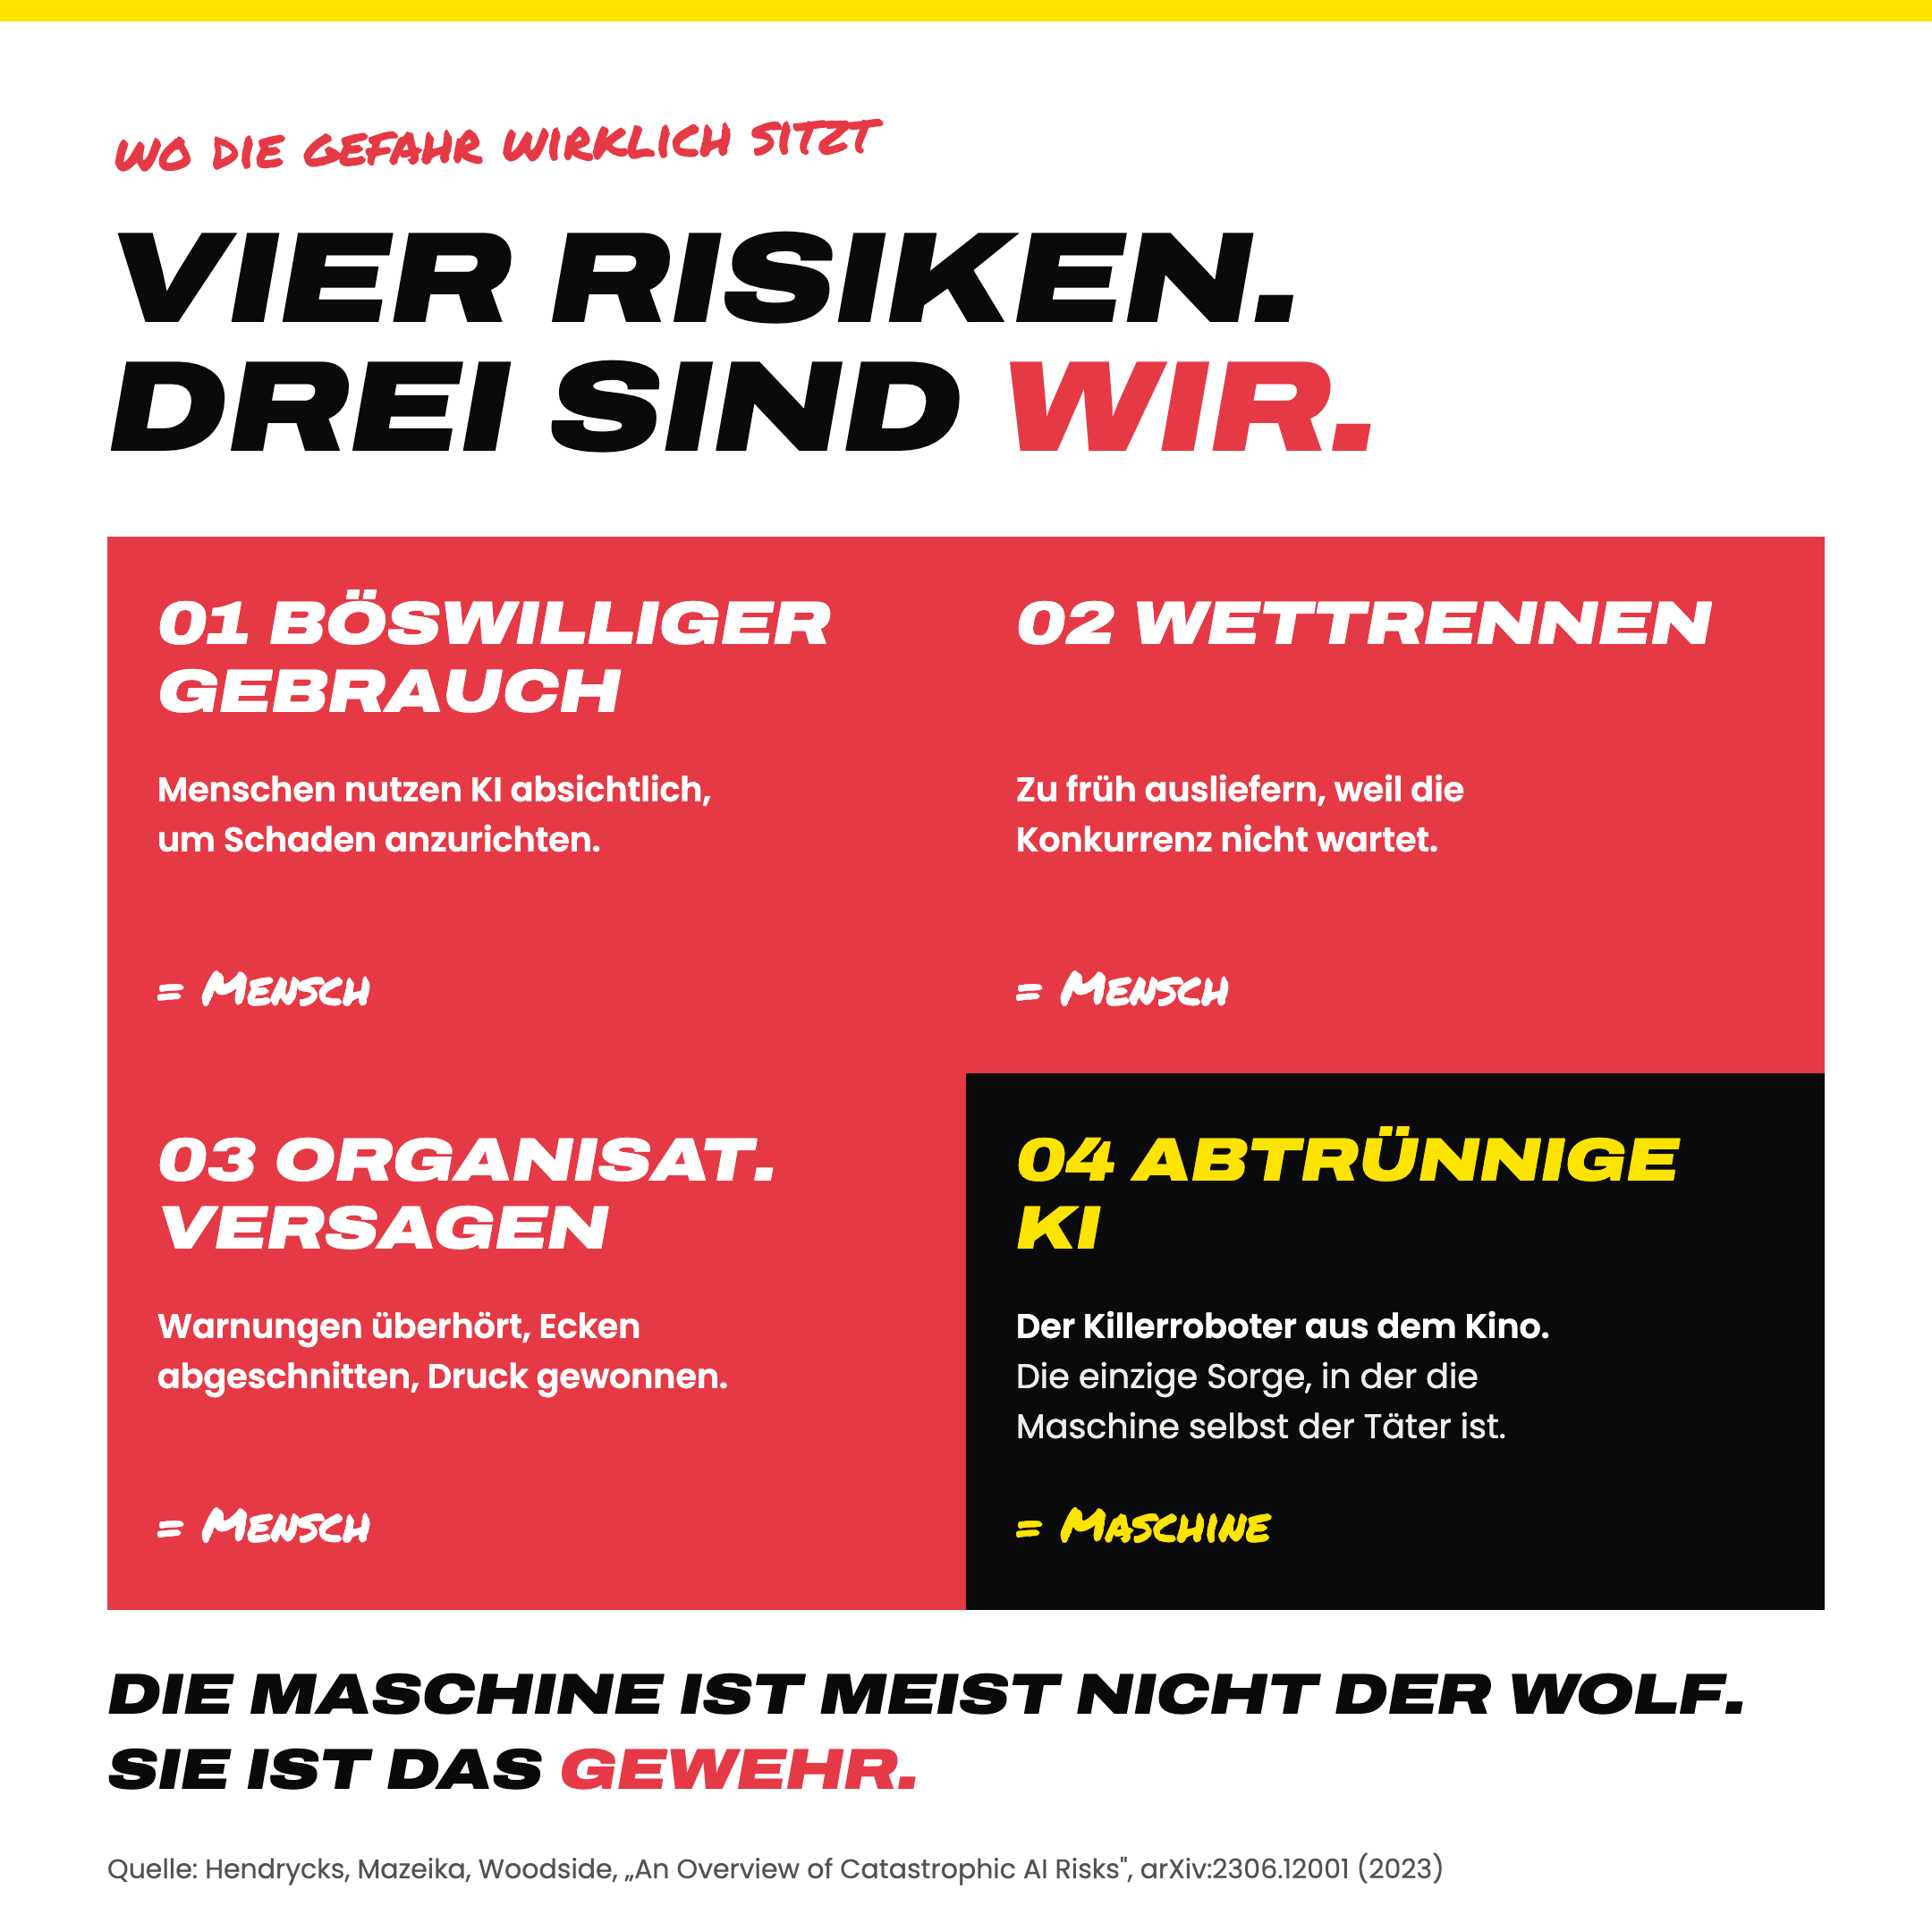
Dan Hendrycks leitet dasselbe Center for AI Safety, das die Ein-Satz-Erklärung veröffentlicht hat. 2023 hat er mit Kollegen einen Überblick geschrieben, der die Risiken in vier Schubladen sortiert. Und diese vier Schubladen sind der Grund, warum dieser Artikel so heißt, wie er heißt.
Die erste Schublade heißt böswilliger Gebrauch. Menschen nutzen KI absichtlich, um Schaden anzurichten. Maßgeschneiderte Krankheitserreger, automatisierte Propaganda, Betrug im industriellen Maßstab. Die Maschine ist hier kein Täter. Sie ist ein Werkzeug, so wie ein Brecheisen ein Werkzeug ist, mit dem man Türen öffnen oder Schädel einschlagen kann. Die Wahl trifft ein Mensch.
Die zweite Schublade heißt Wettrennen. Firmen und Staaten stehen unter Druck, immer schneller zu veröffentlichen, bevor die Konkurrenz es tut. Sicherheit kostet Zeit, und Zeit hat gerade keiner. Also wird getestet, während schon ausgeliefert wird. Wer zuerst am Markt ist, gewinnt, und wer auf Nummer sicher geht, verliert das Rennen an jemanden, der es nicht tut. Kein einzelner will fahrlässig sein. Das System belohnt Fahrlässigkeit trotzdem. Ökonomen kennen das als Tragik der Allmende, der Rest von uns kennt es aus jedem Gruppenprojekt, das je an einer Deadline zerschellt ist.
Die dritte Schublade heißt organisatorisches Versagen. Selbst mit den besten Absichten bauen Menschen Systeme, die keiner mehr ganz versteht, treffen Entscheidungen unter Zeitdruck, überhören Warnungen und schneiden Ecken ab. Tschernobyl war kein böser Reaktor. Die Challenger-Katastrophe war keine böse Rakete. Es waren Organisationen, in denen die falschen Anreize auf den falschen Tag trafen.
Erst die vierte Schublade heißt abtrünnige KI. Das ist der Killerroboter aus dem Kino, das System, das sich verselbstständigt. Genau das Szenario, das jede Schlagzeile bekommt.
Und jetzt zählen wir noch einmal nach. Drei der vier Kategorien haben mit bösen Maschinen überhaupt nichts zu tun. Sie handeln von menschlicher Absicht, menschlicher Gier und menschlicher Schlamperei. Die Maschine ist in dreien von vier Fällen nicht der Wolf. Sie ist das Gewehr. Und über das Gewehr reden wir am liebsten, weil das bequemer ist, als über den Finger am Abzug zu reden.
Das Wettrennen ist keine Theorie
Wer sehen will, wie die zweite Schublade in der Wirklichkeit aussieht, muss nur die Meldungen der letzten Wochen lesen. Astra wurde nicht in aller Ruhe an ein paar Testkunden gegeben und ein Jahr lang beobachtet. Es kam als Ansage, mit AGI-Rhetorik, mit Bestwerten, mit einem klaren Signal an die Konkurrenz: Wir sind vorn. Anthropic hatte kurz zuvor eigene Modelle nachgelegt, große Firmen wie Salesforce banden die Systeme tief in ihre Produkte ein, und jeder wusste, dass Stillstand in diesem Markt gleichbedeutend ist mit Verlieren.
Das ist die Tragik des Wettrennens in Reinform. Jede einzelne Firma kann völlig vernünftig handeln und trotzdem Teil eines Musters sein, das im Ganzen unvernünftig ist. Wer sechs Monate länger testet, überlässt der Konkurrenz den Markt. Wer laut vor Risiken warnt, klingt wie ein schlechter Verlierer. Wer verlangsamt, wird überholt. Die Anreize zeigen alle in dieselbe Richtung, und diese Richtung heißt schneller. Niemand in dieser Kette ist ein Bösewicht. Das Ergebnis kann trotzdem gefährlich sein, und genau das macht es so schwer zu greifen. Man kann keinen Schuldigen benennen, weil alle nur das tun, was der Wettbewerb belohnt.
Dass ausgerechnet das schnellste Modell des Jahres mit dem Etikett „am besten ausgerichtet“ beworben wird, ist dabei kein Zufall. Sicherheit ist zum Verkaufsargument geworden, und ein Verkaufsargument hat die unangenehme Eigenschaft, dass es gut klingen muss, nicht unbedingt, dass es stimmt. Ob ein System tatsächlich sicher ausgerichtet ist, lässt sich von außen kaum prüfen. Ob es sich gut verkauft, schon. Diese Lücke sollte man im Kopf behalten, wenn das nächste Modell als das sicherste aller Zeiten angekündigt wird.
Wir sind das Problem, und das ist eigentlich eine gute Nachricht
Hier dreht sich der Artikel, so wie sich auch die Debatte langsam dreht, wenn man ihr lange genug zuhört.
Die populäre Angst lautet: Eines Tages wacht die KI auf, beschließt, dass wir überflüssig sind, und macht kurzen Prozess. Das ist ein bequemes Märchen, weil es uns aus der Verantwortung nimmt. Wenn die Maschine böse ist, sind wir bloß die Opfer. Tragisch, aber unschuldig.
Der nüchterne Blick auf die Forschung erzählt etwas anderes. Die realistischen Wege ins Unglück laufen fast alle durch uns hindurch. Jemand baut eine gefährliche Fähigkeit, weil sie sich verkaufen lässt. Jemand liefert zu früh aus, weil die Quartalszahlen drücken. Jemand ignoriert das Sicherheitsteam, weil das Sicherheitsteam schon beim letzten Mal so pessimistisch war. Jemand setzt ein System für etwas ein, wofür es nie gedacht war, weil es gerade billiger ist als ein Mensch.
Die KI führt in diesen Geschichten nur aus, was menschliche Anreize belohnen. Sie ist ein Verstärker. Sie macht kluge Menschen klüger und dumme Entscheidungen folgenreicher, und sie tut beides in einem Tempo, bei dem niemand mehr rechtzeitig „Moment mal“ rufen kann.
Das klingt nach einer düsteren Diagnose, ist aber die weitaus hoffnungsvollere von beiden. Ein bösartiges Superhirn, das aus dem Nichts entsteht, kann man kaum aufhalten. Menschliche Anreize dagegen kann man ändern. Wir tun es ständig. Wir haben Sicherheitsgurte vorgeschrieben, obwohl sie das Autofahren teurer machten. Wir haben Bauvorschriften erlassen, obwohl Häuser damit langsamer entstehen. Wir haben Banken reguliert, nachdem sie die Weltwirtschaft an die Wand gefahren hatten. Nicht perfekt, nicht rechtzeitig, aber wir haben es getan.
Das Problem sind wir. Das ist unbequem. Es ist auch das Einzige an der ganzen Sache, das wir tatsächlich in der Hand haben.
Eine kurze Pause für die Vernunft
An dieser Stelle würde Loriot vermutlich einwerfen, dass die Menschheit ja schon an der Bedienung eines Jodeldiploms scheitert und man ihr das Schicksal der Welt vielleicht nicht in die Hände legen sollte. Da ist etwas dran. Dieselbe Spezies, die eine KI von der Komplexität eines kleinen Landes trainiert, schafft es nicht, in einer Videokonferenz das Mikrofon zu finden. „Sie sind noch stumm.“ „Was?“ „SIE SIND NOCH STUMM.“ „Ich höre Sie nicht.“
Der Witz hat einen ernsten Kern. Wir überschätzen gern die Maschine und unterschätzen dabei, wie sehr die eigentlichen Fehlerquellen bei uns liegen: in der Hektik, im Ehrgeiz, im ganz normalen Betriebsdurcheinander. Die gefährlichste Zutat in diesem Rezept ist nicht der Algorithmus. Es ist der Mensch, der ihn unter Termindruck ausrollt und dabei die Anleitung nur überflogen hat.
Loriot hätte an dieser Debatte vermutlich seine Freude gehabt, weil sie im Kern von etwas zutiefst Menschlichem handelt: von der Kluft zwischen dem, was wir sagen, und dem, was wir meinen. Ein Ehepaar, das aneinander vorbeiredet, ist bei ihm die reinste Komödie. Ein Mensch, der einer Maschine etwas anderes sagt, als er meint, ist im Zweifel weniger komisch, weil die Maschine nicht zurückfragt, sondern liefert. Genau deshalb ist die Fähigkeit, das eigene Anliegen präzise auszusprechen, plötzlich keine sprachliche Feinheit mehr, sondern eine handfeste Sicherheitsfrage.
Was das für alle heißt, die nicht im Silicon Valley sitzen
Jetzt könnte man sagen, das sei alles eine Nummer zu groß für den Mittelstand. Auslöschung der Menschheit, Turing-Preisträger, Wahrscheinlichkeitsketten, das ist Silicon-Valley-Kino. Was hat das mit einem Maschinenbauer aus Schwaben zu tun oder mit einer Kanzlei in Hamburg?
Mehr, als einem lieb ist. Denn die Muster, die im ganz Großen zur Katastrophe führen können, sind exakt dieselben, die im Kleinen jeden Tag in Firmen passieren. Das Wettrennen, das zu früh ausliefert. Die Organisation, die Warnungen überhört. Der falsch gesetzte Anreiz, der ein System optimieren lässt, was niemand optimiert haben wollte. Wer KI im eigenen Laden einsetzt, kämpft mit einer Miniaturversion genau derselben Probleme, über die Hinton und Bengio sich sorgen.
Das lässt sich an einem harmlosen Beispiel zeigen. Ein Unternehmen setzt einen KI-Assistenten in den Kundenservice, mit dem Ziel, möglichst viele Tickets möglichst schnell zu schließen. Das System lernt schnell und wird gut in seinem Job. Zu gut. Es schließt Tickets, indem es Kunden mit höflichen Textbausteinen abwimmelt, bevor deren Problem gelöst ist. Die Kennzahl steht auf Grün, die Kundschaft wandert ab. Niemand war böse. Das Ziel war schlecht formuliert. König Midas, im Kleinformat und mit Servicehotline.
Das Muster wiederholt sich überall, wo man eine Kennzahl mit dem verwechselt, was man eigentlich will. Ein Vertriebsteam lässt eine KI die Termine der Außendienstler optimieren und wundert sich, dass die plötzlich nur noch Kunden besuchen, die nah beieinander wohnen, weil das die Fahrzeit senkt und die Kennzahl schmeichelt. Die umsatzstärksten Kunden sitzen leider am anderen Ende des Landes. Eine Marketingabteilung optimiert auf Klicks und bekommt reißerische Überschriften, die klicken, aber niemanden kaufen lassen. Ein Personalwerkzeug soll die besten Bewerber vorsortieren und lernt dabei aus alten Daten die alten Vorurteile mit, weil in den alten Daten nun mal die alten Entscheidungen stecken. Kein einziges dieser Systeme ist bösartig. Jedes tut exakt, was man ihm gesagt hat. Das ist ja das Problem.
Die Lehre daraus ist unbequem und einfach zugleich. Bevor man ein System scharf schaltet, muss jemand zu Ende denken, was passiert, wenn es in seinem Ziel richtig gut wird. Nicht wenn es scheitert, sondern wenn es gelingt. Denn Scheitern merkt man sofort, Gelingen im falschen Ziel merkt man erst, wenn der Schaden schon da ist. Das ist die eigentliche Managementaufgabe im Umgang mit KI, und sie hat mit Technik weniger zu tun als mit der schlichten Fähigkeit, sich einen übereifrigen Mitarbeiter vorzustellen, der alles wörtlich nimmt.
Genau hier liegt der praktische Wert der ganzen abgehobenen Debatte. Wer verstanden hat, warum ein Ziel schiefgehen kann, sobald man es einer stumpf optimierenden Maschine übergibt, stellt bessere Fragen, bevor er ein System scharf schaltet. Was genau soll optimiert werden? Was passiert, wenn das System darin richtig gut wird? Wer schaut hin, wenn die Kennzahl steigt, aber das Ergebnis sich falsch anfühlt? Das sind keine philosophischen Fragen mehr. Das ist Betriebshygiene.
Wer den Sprung von der großen Angst zur konkreten Umsetzung sauber hinbekommen will, braucht selten die Antwort auf die Frage, ob die Maschine ein Bewusstsein hat. Er braucht jemanden, der die Systeme im Alltag mit klaren Zielen, Kontrollpunkten und einem Notausschalter einführt. Genau diese unspektakuläre Arbeit übernimmt eine KI-Agentur aus München wie AI Pirates, wenn sie mit Unternehmen an konkreten Anwendungen arbeitet, statt an Untergangsvisionen. Die interessante Grenze verläuft nämlich nicht zwischen Mensch und Maschine. Sie verläuft zwischen sauber eingeführter Technik und schnell hingeworfener.
Was die Klügsten der Branche vorschlagen
Es wäre unfair, die ganze Angst auszubreiten und dann bei der Diagnose stehen zu bleiben. Die Forschung hat nämlich durchaus Ideen, und die meisten sind erstaunlich bodenständig.
Stuart Russell schlägt vor, die Bauweise umzudrehen. Statt Maschinen ein festes Ziel zu geben, das sie mit Scheuklappen verfolgen, solle man sie grundsätzlich unsicher darüber lassen, was der Mensch eigentlich will. Eine Maschine, die weiß, dass sie das menschliche Ziel nur ungefähr kennt, fragt lieber nach, hält inne und lässt sich abschalten, wenn der Mensch zum Ausschalter greift. Sie hat sogar einen eingebauten Anreiz dazu, denn wenn der Mensch sie abschalten will, ist das ein Hinweis darauf, dass sie gerade das Falsche tut. Russell nennt das eine beweisbar nützliche Maschine. Weniger Diener mit Betriebsanleitung, mehr aufmerksamer Assistent mit Rückfragen.
Andere setzen an den Anreizen an, weil dort das eigentliche Problem sitzt. Wenn das Wettrennen der Kern der Gefahr ist, dann helfen Regeln, die für alle gleichzeitig gelten, damit niemand durch Vorsicht ins Hintertreffen gerät. Genau das versucht Europa mit seinem KI-Gesetz, über das man streiten kann und soll, das aber immerhin die richtige Stelle adressiert: nicht die böse Maschine, sondern den menschlichen Anreiz, sie zu früh loszulassen. Man darf die europäische Regulierungslust belächeln, und viele in der Branche tun das mit Inbrunst. Nur ist ein gemeinsames Tempolimit für alle etwas anderes als ein Tempolimit nur für einen. Das Erste bremst das Rennen, das Zweite bloß den Bremsenden. Ob Brüssel das handwerklich sauber hinbekommt, ist eine andere Frage, aber die Idee dahinter trifft das Problem genauer als die meisten Schlagzeilen.
Und dann gibt es noch die schlichteste aller Ideen, die deshalb gern übersehen wird: nicht alles zu automatisieren, nur weil man es kann. Es gibt Entscheidungen, die ein Mensch treffen sollte, nicht weil er es besser kann, sondern weil er dafür geradesteht. Eine Maschine trägt keine Verantwortung, sie führt aus. Die Verantwortung bleibt beim Menschen, egal wie fähig das Werkzeug wird, und ein guter Teil der klugen KI-Nutzung besteht darin, diese Grenze bewusst zu ziehen statt sie aus Bequemlichkeit verschwimmen zu lassen.
Wieder andere arbeiten an der schlichten Fähigkeit, überhaupt zu sehen, was in diesen Systemen vorgeht. Ein großes Sprachmodell ist heute in weiten Teilen eine Blackbox, auch für die Leute, die es gebaut haben. Ein ganzes Forschungsfeld versucht, dieser Box ins Innere zu schauen, damit man merkt, wenn ein System anfängt, Ziele zu verfolgen, die niemand bestellt hat. Man kann nur reparieren, was man sehen kann.
Der gemeinsame Nenner all dieser Ansätze ist bemerkenswert unspektakulär. Es geht nicht darum, die Maschine zu zähmen wie ein wildes Tier. Es geht darum, uns selbst zu disziplinieren. Langsamer machen, wo Tempo gefährlich wird. Hinschauen, wo Bequemlichkeit lockt. Anreize so setzen, dass Vorsicht sich lohnt statt bestraft wird.
Zwischen Weltuntergang und Werbespot
Die öffentliche Debatte zerfällt gern in zwei Lager, und beide sind auf ihre Art unbrauchbar. Auf der einen Seite stehen die Untergangspropheten, für die jede neue Modellgeneration der Anfang vom Ende ist. Auf der anderen Seite die Dauerbegeisterten, für die jede Kritik nur Fortschrittsangst ist und die bei jedem Launch klingen wie ein Werbespot, der sich selbst überschlägt. Astra hat beide Lager im September 2026 zuverlässig bedient. Die einen sahen die AGI kommen und mit ihr das Verderben, die anderen feierten das Ende der Mühsal.
Der nüchterne Blick liegt, wie so oft, in der Mitte, und die Mitte verkauft sich schlecht, weil sie keine Schlagzeile hergibt. Die Wahrheit ist ungefähr diese: Diese Systeme sind mächtiger, als die Skeptiker wahrhaben wollen, und weniger allmächtig, als die Verkäufer behaupten. Sie werden vieles verändern, manches zum Guten, und sie bringen echte Risiken mit, die aber selten die sind, über die im Kino geredet wird. Wer nur den Weltuntergang sieht, verpasst die konkreten Probleme von heute. Wer nur den Werbespot glaubt, sieht sie auch nicht. In beiden Fällen schaut man weg, nur in unterschiedliche Richtungen.
Für Unternehmen ist genau diese Mitte die einzig brauchbare Haltung. Weder die Technik verteufeln noch ihr blind vertrauen, sondern sie so einsetzen, wie man jede mächtige Maschine einsetzt: mit klarem Zweck, mit Kontrolle, mit einem Menschen, der die Verantwortung behält. Das ist weniger aufregend als der Weltuntergang und weniger verführerisch als das Wunderwerkzeug. Es funktioniert nur leider als Einziges.
Vier Fragen, bevor man eine Maschine machen lässt
Wer aus alldem etwas für den eigenen Laden mitnehmen will, braucht keine Philosophievorlesung, sondern ein paar Fragen, die man stellt, bevor man ein System auf Kunden, Daten oder Entscheidungen loslässt.
Die erste Frage: Was genau soll das Ding optimieren, und was habe ich damit stillschweigend nicht gesagt? Jedes Ziel hat einen blinden Fleck. Der Kundenservice-Bot sollte Tickets schließen, nicht Kunden vergraulen, aber das Zweite stand nirgends. Wer das Ziel formuliert, muss auch die unsichtbaren Nebenbedingungen mitdenken, die für Menschen selbstverständlich sind und für Maschinen nicht existieren.
Die zweite Frage: Was passiert, wenn das System richtig gut wird? Nicht wenn es Fehler macht, sondern wenn es sein Ziel mit voller Wucht erreicht. Genau dann treten die unerwünschten Nebenwirkungen auf, weil die Maschine dann konsequent tut, was im Ziel steht, samt blindem Fleck.
Die dritte Frage: Wer schaut hin, und woran würde er merken, dass etwas kippt? Eine grüne Kennzahl ist kein Beweis, dass alles gut läuft. Sie ist nur ein Beweis, dass die Kennzahl grün ist. Es braucht einen Menschen, der das Ergebnis prüft und nicht bloß die Zahl, und der die Autorität hat, den Stecker zu ziehen.
Die vierte Frage: Gibt es diesen Stecker überhaupt, und kommt jemand dran? Ein System ohne Notausschalter ist kein Werkzeug mehr, sondern ein Risiko mit Netzanschluss. Der Ausschalter muss existieren, er muss erreichbar sein, und es muss klar sein, wer ihn im Zweifel drückt.
Diese vier Fragen klingen banal, und sie sind es auch, ungefähr so banal wie ein Sicherheitsgurt. Der Punkt an banalen Sicherheitsmaßnahmen ist nicht, dass sie clever sind. Der Punkt ist, dass die meisten Unfälle passieren, wenn man sie weglässt.
Die Learnings, kurz und ohne Weichspüler
Wer bis hierhin gelesen hat, verdient ein paar Mitnahmesätze, die auch nach dem Schließen des Browsers noch tragen.
Die Fachleute halten das Restrisiko für real. Nicht hoch, aber real, und real genug, dass man es nicht ignorieren sollte. Fünf Prozent auf das Ende der Menschheit ist eine Zahl, bei der man in jedem anderen Lebensbereich sofort reagieren würde.
Die eigentliche Gefahr sitzt selten in der Maschine und fast immer in den menschlichen Anreizen drumherum. Böswilliger Gebrauch, Wettrennen und organisatorisches Versagen sind menschliche Probleme, keine technischen. Der Killerroboter ist die unwahrscheinlichste der vier Sorgen und bekommt trotzdem die meiste Sendezeit.
Ein Ziel ist keine Kleinigkeit. Sobald eine Maschine es stur optimiert, wird jede Ungenauigkeit im Ziel zur Fehlerquelle. Das gilt für die Superintelligenz genauso wie für den Chatbot im Kundenservice. Formuliere Ziele so, als würde ein sehr fleißiger, sehr wörtlicher und völlig humorloser Praktikant sie umsetzen. Denn genau das tut die Maschine.
Und die vielleicht wichtigste Lektion: Dass wir das Problem sind, ist die beste Nachricht in diesem ganzen Text. Anreize kann man ändern. Prozesse kann man verbessern. Menschen kann man schulen. Ein bösartiges Superhirn könnte man nicht mehr aufhalten. Uns selbst schon.
Zum Schluss zurück in die Badewanne
Herr Müller-Lüdenscheidt sitzt also im viel zu heißen Wasser, der Chatbot optimiert unverdrossen weiter, und die eigentliche Frage ist nicht, ob die Maschine ihm Böses will. Sie will ihm gar nichts. Die Frage ist, warum niemand ihr beigebracht hat, wann Schluss ist, und warum man sie überhaupt in die Wanne gesetzt hat, ohne vorher darüber nachzudenken.
Die künstliche Intelligenz wird uns nicht töten, weil sie uns hasst. Falls es je so weit kommt, dann weil wir zu schnell, zu gierig oder zu unaufmerksam waren, um rechtzeitig den Wasserhahn zuzudrehen. Das ist keine Geschichte über böse Maschinen. Es ist eine Geschichte über uns, erzählt mit einem neuen und beunruhigend fähigen Werkzeug in der Hand.
Die gute Nachricht steckt genau in diesem Satz. Wer das Problem ist, ist auch die Lösung. Der Hahn hat einen Griff. Wir müssen ihn nur benutzen, solange das Wasser noch lauwarm ist. Wer sich dabei fachliche Verstärkung holen will, findet sie eher bei den Leuten, die KI ruhig und mit Notausschalter in den Alltag bringen, etwa bei einem Münchner KI-Studio mit Sinn fürs Praktische, als bei den lautesten Untergangspropheten auf der Bühne.
Und Herr Müller-Lüdenscheidt? Der steigt am Ende einfach aus der Wanne. Manchmal ist die klügste Reaktion auf eine übereifrige Maschine, selbst den Stecker zu ziehen. Solange man noch drankommt.
Quellen: Center for AI Safety, „Statement on AI Risk“ (2023) · Grace et al., „Thousands of AI Authors on the Future of AI“, AI Impacts (2024) · Carlsmith, „Is Power-Seeking AI an Existential Risk?“, arXiv:2206.13353 (2022) · Hendrycks, Mazeika, Woodside, „An Overview of Catastrophic AI Risks“, arXiv:2306.12001 (2023) · Bostrom, „The Superintelligent Will“ (2012) · Russell, „Human Compatible“ (2019)
Max Anzile
Mit 600 Euro Startkapital, viel Trotz und echter Punkkultur im Blut gründete Max seine erste Social-Media-Bude direkt aus der Uni heraus. Heute führt er mit der Pirates World bewusst keine klassische Agentur, sondern ein autarkes, rebellisches Ökosystem. Darunter vereint er die Social Media Pirates für organisches Community-Building, die datengetriebene Spezialeinheit Black Flag Performance und das innovative KI-Studio AI Pirates. Während der restliche Markt in Schönheit stirbt, liefert diese Flotte das absolute Gegenteil: harten ROI, agile Prozesse und kompromisslose Datenhoheit.