24.000 Fake-Konten: So zapft China die US-KI zum Lernen an
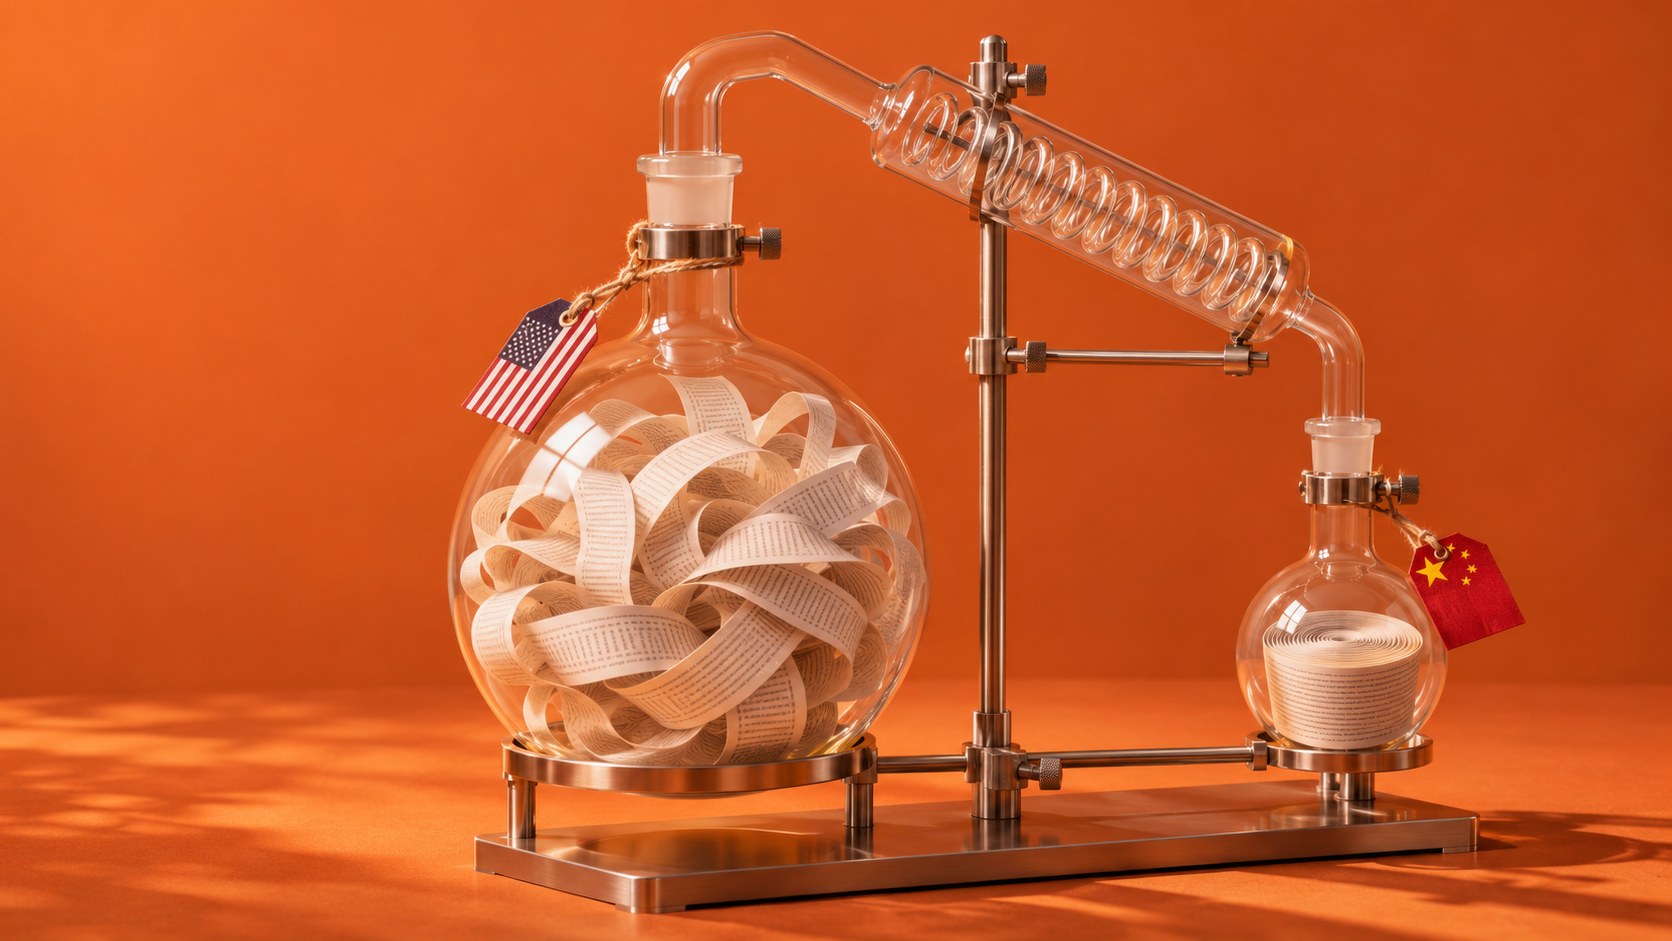
Washington sperrt die Chips, doch das Wissen der US-Modelle fließt trotzdem ab: Prompt für Prompt, als ganz normale Textantwort. Für Chinas Labore ist das der schnellste Weg nach vorn, aber nicht der Weg an die Spitze.
Innerhalb von elf Tagen im Februar 2026 haben die drei wichtigsten KI-Labore der USA dasselbe Problem öffentlich gemacht. Google meldete Kopierversuche an Gemini, OpenAI schrieb dem Kongress einen Brandbrief über DeepSeek, Anthropic legte Zahlen zu Claude vor. Gemeint ist immer dieselbe Technik: Distillation. Man fragt ein großes Modell so lange aus, bis man mit seinen Antworten ein eigenes trainieren kann. Kein Hack, kein Einbruch, keine Schmuggelware. Nur sehr viele Fragen.
Drei Labore haben einen Feind: die eigene Schnittstelle
Den Auftakt machte Google. Die Threat Intelligence Group des Konzerns berichtete am 12. Februar von einer Zunahme sogenannter Model-Extraction-Versuche. Gemeint ist Diebstahl geistigen Eigentums über legitime Zugänge wie APIs statt über Netzwerkangriffe, so IT Brief. In einem Fall habe eine einzelne Kampagne mehr als 100.000 Prompts an Gemini geschickt, berichtet Android Authority. Eine Masche wird besonders hervorgehoben: Die Angreifer versuchten, Gemini zur Ausgabe seiner vollständigen Denkprozesse zu zwingen statt der knappen Zusammenfassung für Nutzer. Google ordnet die Versuche vor allem privaten Unternehmen und Forschern zu, die die Logik der Modelle klonen wollen, nicht staatlichen Hackergruppen.
Am selben Tag ging OpenAI in die Offensive. In einem Memo an den China-Ausschuss des US-Repräsentantenhauses warf das Unternehmen DeepSeek vor, mit unfairen und immer raffinierteren Methoden Ergebnisse aus führenden US-Modellen abzuschöpfen, um die nächste Generation seines Chatbots R1 zu trainieren, berichtet Bloomberg. Konten mit Verbindung zu DeepSeek-Mitarbeitern hätten Zugangsbeschränkungen über verschleierte Router von Drittanbietern umgangen. Bemerkenswert ist das Eingeständnis zwischen den Zeilen: Das Memo legt nahe, dass OpenAIs Abwehr das Problem nicht beseitigt hat, schreibt die Taipei Times.
24.000 Fake-Konten für ein Nachhilfeprogramm
Die härtesten Zahlen lieferte Anthropic am 23. Februar. Nach Angaben im Anthropic-Blog führten DeepSeek, Moonshot und MiniMax über rund 24.000 betrügerische Konten mehr als 16 Millionen Unterhaltungen mit Claude, unter Verstoß gegen Nutzungsbedingungen und regionale Zugangsbeschränkungen. Der Löwenanteil entfiel demnach auf MiniMax mit mehr als 13 Millionen Austauschen, Moonshot kam auf mehr als 3,4 Millionen, DeepSeek auf mehr als 150.000. Im Fall von DeepSeek ließen sich die Konten anhand von Metadaten konkreten Forschern des Labors zuordnen, berichtet TechInformed.
Alle drei Darstellungen sind Eigenangaben von Unternehmen, die zugleich Wettbewerber sind. Das muss man wissen, wenn man sie liest. Die Muster gleichen sich trotzdem auffällig: viele Konten, verschleierte Zugänge, gezielte Jagd auf Denkketten und Programmierfähigkeiten.
Warum Abschreiben ökonomisch brillant ist
Jetzt die unbequeme Frage: Ist das nicht einfach der klügere Weg? Aus Controller-Sicht spricht viel dafür. Der Lehrer hat die teure Arbeit erledigt: Rechenzentren, Forschung, unzählige Sackgassen. Der Schüler bekommt das Ergebnis, ohne den Weg zu bezahlen. Genau diesen Effekt beschreibt Google selbst: Die Methode kann Kosten und Zeit für den Bau eines Konkurrenzmodells senken.
Wie groß die Abkürzung ist, belegt ausgerechnet ein Papier aus China. Forscher der Shanghai Jiao Tong University zeigten im November 2024 auf arXiv, dass ein Basismodell, nachgeschult auf nur einigen Zehntausend Denkketten aus OpenAIs o1, dessen Vorgänger o1-preview beim amerikanischen Mathe-Wettbewerb AIME übertraf. Zehntausende Beispiele statt Milliardeninvestition. Das ist Fast-Follower-Strategie in Reinform.
Der Nachteil, den sich jede Kopie selbst einzieht
Der Haken steht im selben Papier und die Autoren schreiben ihn selbst hinein. Per Distillation trainierte Modelle sind naturgemäß an die Fähigkeiten ihres Lehrers gebunden, ein Deckeneffekt, der echten Fortschritt bremsen kann. Ihre „bittere Lektion“: Entscheidend seien Forscher, die aus Grundprinzipien denken, so die Autoren auf arXiv.
Übersetzt: Wer nur abschreibt, wird bestenfalls Zweitbester. Und er bleibt abhängig. Sperrt der Lehrer Konten, verändert er seine Ausgaben oder verbirgt er seine Denkketten, versiegt die Quelle. Genau dort setzen die US-Labore an. Anthropic investiert nach eigenen Angaben in Erkennungssysteme, die Angriffsmuster im API-Verkehr aufspüren und argumentiert, dass auch das Abschöpfen in diesem Maßstab viel Rechenleistung braucht. Eingeschränkter Chipzugang begrenze damit beides, das eigene Training und das Absaugen. Das ist plausibel, aber es ist auch die Position eines Unternehmens, das von strengen Exportkontrollen profitiert.
Ihr Produkt ist eine Antwort? Dann ist es kopierbar
Die Lehre reicht weit über die Geopolitik hinaus. Googles Chefanalyst John Hultquist erwartet, dass nach Gemini auch die KI-Werkzeuge anderer Unternehmen solche Angriffe erleben werden, berichtet eWeek. Wer ein Modell, einen Agenten oder einen Datenservice per Schnittstelle anbietet, liefert im Zweifel das Trainingsmaterial für seinen eigenen Nachahmer gleich mit.
Ihr Burggraben ist nicht das, was Ihr System antwortet, sondern das, was sich nicht abfragen lässt. Exklusive Daten, Kundenbeziehungen, Integration in Prozesse, Tempo bei der nächsten Version. Und wer selbst kleine Spezialmodelle aus großen destillieren will, was technisch legitim und oft sinnvoll ist, sollte vorher die Nutzungsbedingungen seines Anbieters lesen. Google stellt klar: Distillation ist eine anerkannte Methode, aber ohne Erlaubnis verstößt sie gegen die Regeln.
Business Punk Check
Ist Abschreiben der bessere Weg? Für den, der Zweiter sein will, eindeutig ja: Distillation ist die billigste Aufholjagd der Technologiegeschichte. Für den, der Erster sein will, nein, denn keine Kopie wird klüger als ihr Original. Peking kauft sich Tempo und bezahlt mit Abhängigkeit.
Der blinde Fleck liegt in Washington. Die USA kontrollieren seit Jahren, wo Chips hingehen, aber das Wertvollste, was diese Chips produzieren, verkaufen die eigenen Champions per API in die ganze Welt. Chips kann man an der Grenze stoppen, Antworten nicht. Die neue Exportkontrolle ist kein Zollbeamter, sondern eine Betrugserkennung im Login.
Häufig gestellte Fragen
Was ist Distillation bei KI-Modellen?
Bei der Distillation wird ein kleineres Modell mit den Antworten eines größeren trainiert. Das große Modell dient als Lehrer, das kleine lernt aus dessen Ausgaben. Forscher der Shanghai Jiao Tong University zeigten 2024, dass dafür einige Zehntausend Beispiele aus OpenAIs o1 genügen können.
Ist Distillation illegal?
Distillation ist eine anerkannte Trainingsmethode, die KI-Labore auch für eigene Modelle nutzen. Wer dafür ohne Erlaubnis die Modelle eines anderen Anbieters ausfragt, verstößt jedoch gegen dessen Nutzungsbedingungen. Google wertet solche Fälle als Diebstahl geistigen Eigentums.
Welche chinesischen KI-Firmen sollen US-Modelle kopiert haben?
Anthropic beschuldigt DeepSeek, Moonshot und MiniMax, über rund 24.000 betrügerische Konten mehr als 16 Millionen Unterhaltungen mit Claude geführt zu haben. OpenAI erhob im Februar 2026 in einem Memo an den US-Kongress ähnliche Vorwürfe gegen DeepSeek. Es handelt sich um Angaben der Unternehmen.
Helfen Exportkontrollen gegen Distillation?
Exportkontrollen stoppen Chips, aber keine Textantworten, die über Schnittstellen abgerufen werden. Anthropic argumentiert, dass Distillation in großem Maßstab dennoch viel Rechenleistung benötigt und Chipbeschränkungen sie deshalb bremsen. Zusätzlich setzen die Anbieter auf Erkennungssysteme und Kontosperren.
Quellen: Anthropic, Bloomberg, Taipei Times, IT Brief, Android Authority, eWeek, TechInformed, arXiv, KI-unterstützt
Uli Weißgerber
Seit über 25 Jahren verbindet er Medien, Marketing und Technologie. Von Sport1.de über ProSiebenSat.1 und Bertelsmann bis zur Entwicklung innovativer Geschäftsmodelle. Mit getperformance revolutionierte er das TV-Tracking und brachte Marken wie Trivago ins Fernsehen. Als Unternehmer entwickelte er mit seinem Team den VIPS – Value & Impact Publishing Service und bespielt damit unter anderem digitale Plattformen wie Promipool, Buzzfeed.de und Business-Punk.com.